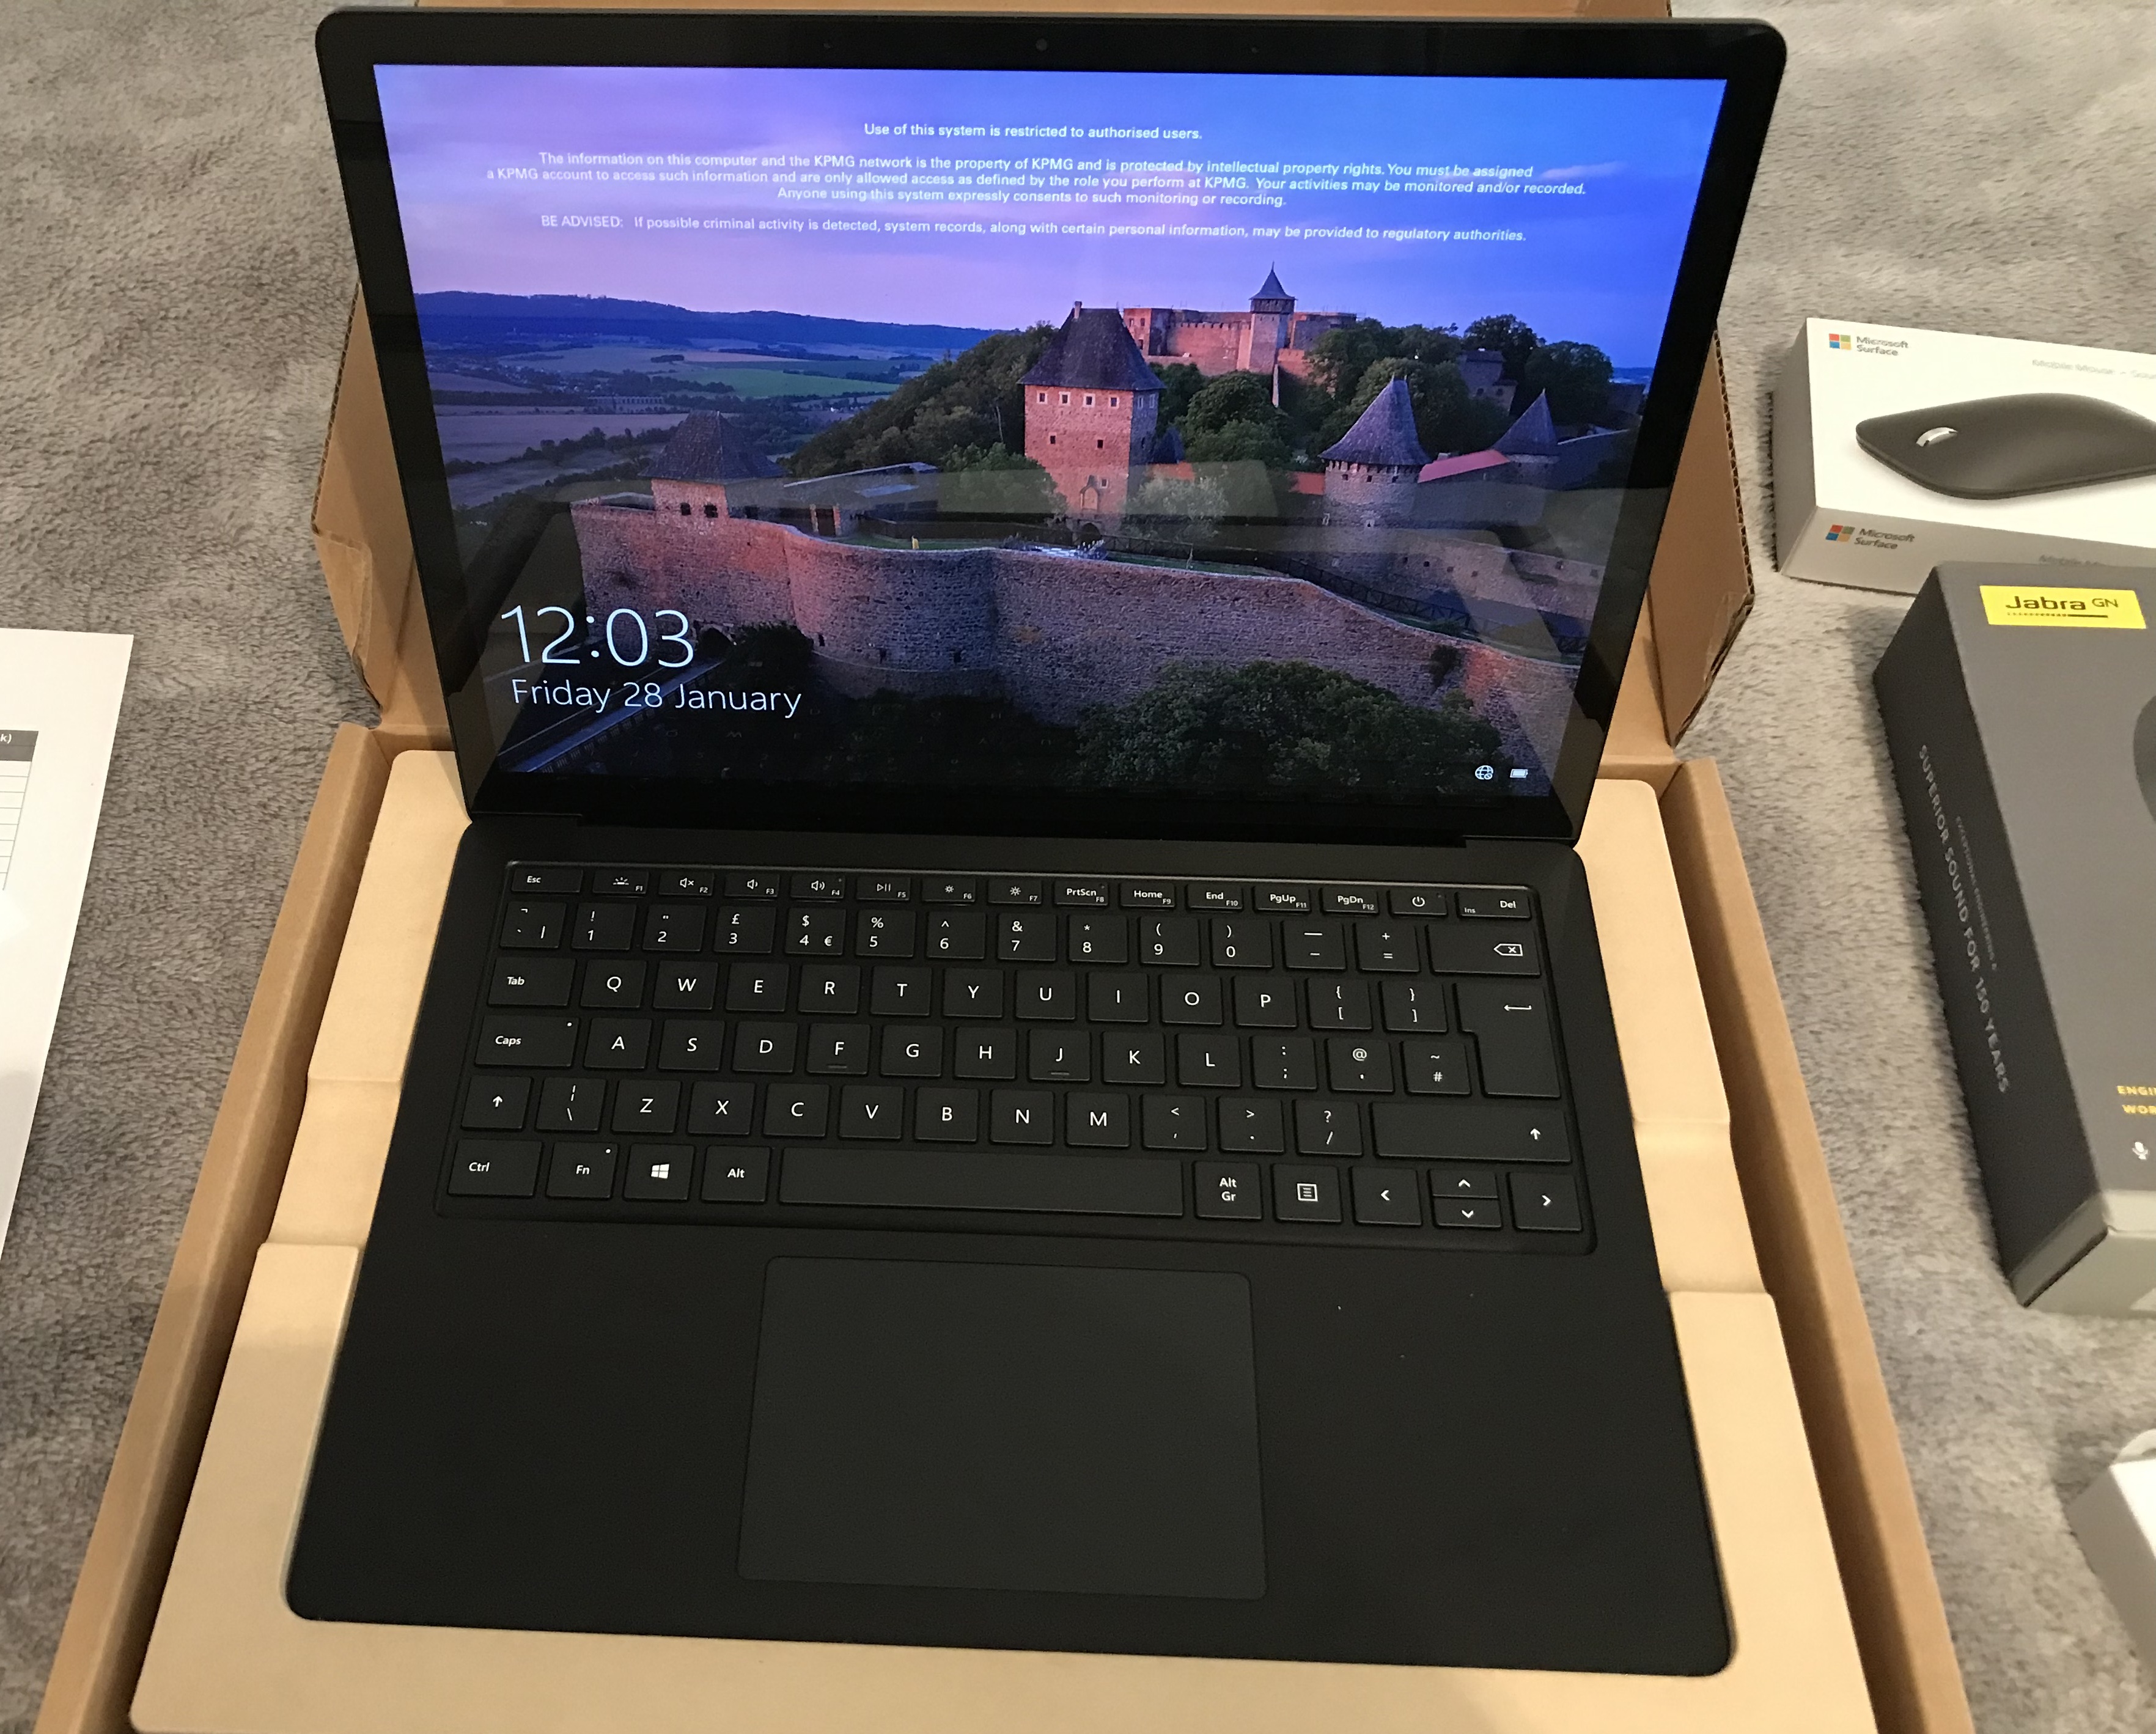
Gdy świadczysz usługi IT dla jednej z firm "Wielkiej Czwórki" audytorskiej, standardowe zasady wsparcia technicznego nie mają zastosowania. Przez trzy lata byłem częścią dedykowanego polskiego zespołu zajmującego się wyłącznym zdalnym wsparciem drugiego poziomu (2nd Line) dla KPMG UK, działając w ramach ogromnego kontraktu korporacyjnego za pośrednictwem globalnego dostawcy IT Hemmersbach.
W naszym wewnętrznym projekcie — nazwanym TRIAGE — nasz zespół służył jako ostateczna warstwa rozstrzygająca. W przypadku ponad 90% wszystkich zaawansowanych problemów technicznych, które do nas trafiły, byliśmy ostatnim przystankiem. Nie byliśmy biurkiem pośrednim; odpowiadaliśmy za problem do momentu, gdy użytkownik w pełni wrócił do pracy.
Pokonywanie rygorystycznych umów SLA
W globalnym środowisku korporacyjnym odejście od komputera bez rozwiązania problemu nie wchodzi w grę. Konsultanci finansowi, audytorzy i starsi partneri polegają na bezproblemowym czasie pracy, aby bezpiecznie prowadzić wielomilionowe projekty.
Osiągając średnio ponad 150 złożonych zgłoszeń miesięcznie na jednego inżyniera, nasz zespół utrzymał wyjątkowy wskaźnik **Rozwiązania przy Pierwszym Kontakcie (FCR)** na poziomie **80%**. Działaliśmy w oparciu o bezwzględne umowy poziomu usług (SLA), udowadniając, że duża skala i wysoka dokładność techniczna mogą iść w parze, jeśli zespół odpowiednio zarządza przepływem pracy.
Współpraca z zespołami 3rd Line na naszych warunkach
Kiedy problem wymagał kontaktu z inżynierami trzeciego poziomu (3rd Line) lub wyspecjalizowanymi programistami, dynamika była wysoce współpracująca. Nie rzucaliśmy po prostu zgłoszenia i nie uciekaliśmy.
Zamiast tego diagnozowaliśmy główną przyczynę, wyciągaliśmy niezbędne logi systemowe i angażowaliśmy się bezpośrednio w pracę z zespołami deweloperskimi. Kiedy wydawali globalną poprawkę lub niestandardową poprawkę doraźną (hotfix), zgłoszenie wracało do nas. To my byliśmy odpowiedzialni za wdrożenie poprawki, przetestowanie stabilności w lokalnym środowisku użytkownika i zweryfikowanie ostatecznego rozwiązania. Utrzymali absolutną odpowiedzialność od początku do końca.
Nasze główne pole bitwy technicznej
Utrzymanie stabilności tysięcy korporacyjnych punktów końcowych wymagało szerokiego i niezawodnego zestawu umiejętności infrastrukturalnych. Podczas każdej zmiany nasz zakres operacyjny obejmował kilka głównych filarów:
- Zarządzanie Active Directory: Projektowanie uprawnień, tworzenie kont korporacyjnych infrastruktury, zarządzanie grupami zabezpieczeń i egzekwowanie standardów zgodności korporacyjnej.
- Strojenie Wirtualizacji (VDI/VM): Tworzenie nowych instancji, instalowanie krytycznego oprogramowania na Windows Server oraz optymalizacja wydajności środowisk pulpitów zdalnych.
- Bezpieczna Łączność Zdalna: Zdalne izolowanie i naprawianie globalnych usterek połączeń w sieciach VPN Cisco AnyConnect i Palo Alto GlobalProtect.
- Audyty Baz Danych i Telemetrii: Wykorzystanie SQL Server Management Studio (SSMS) do ekstrakcji danych i audytu konfiguracji punktów końcowych, obok diagnostyki sieciowej (DNS/TCP/IP).

Napędzanie dynamiki pracy za pomocą PowerShell
Przy tak dużej liczbie zgłoszeń ręczna powtarzalność jest ogromnym wąskim gardłem. Aby utrzymać wyjątkowo niski czas rozwiązywania problemów, mocno skupiłem się na rozwijaniu niestandardowych skryptów **PowerShell** i **CMD**.
Automatyzując powtarzalne zadania — takie jak wdrożenia oprogramowania, odświeżanie profili użytkowników i konfiguracje sieciowe — zamieniliśmy złożone 20-minutowe sesje rozwiązywania problemów w zautomatyzowane 10-sekundowe akcje w tle. Ten nacisk na tworzenie skryptów pozwolił naszemu zespołowi utrzymać kolejkę w ryzach i zielone wskaźniki SLA.